哈希表(HashMap)
哈希表(hash table),又称散列表,它通过建立键 key 与值 value 之间的映射,实现高效的元素查询。具体而言,我们向哈希表中输入一个键 key ,则可以在O(1)时间内快速获取对应的值 value 。
基本概念
对于一对 key-value,哈希函数的计算过程分为以下两步。
- 通过某种哈希算法
hash()计算得到哈希值。 - 将哈希值对桶数量(数组长度)
capacity取模,从而获取该key对应的数组索引index。
index = hash(key) % capacity所有的操作均需要用到这个index, 例如插入数据将数据放在index位置上,查询直接查询index位置上数据。
哈希冲突
哈希函数的本质是将一个大的集合中元素,映射到一个固定空间大小集合的元素的操作。那么就存在两个不同的key1、key2,经过哈希函数计算后的值是一样的情况,这种情况称为哈希冲突,因为key1、key2经过哈希后结果是一样的,没法区分。这个时候需要使用一些方法来解决哈希冲突,常用的方法是开放寻址法和拉链法。
开放寻址法
核心是依次探测和比较数组中的元素以判断目标键值对是否存在于哈希表中。
如果我们使用开放寻址法来实现哈希表,那么实现哈希表底层的数据结构就是数组。因为数组的长度有限,向哈希表写入键值对时会从哈希计算出的索引(index = hash(key) % capacity )开始遍历,当index位置已经存储了数据后,则往后寻找一个不为空的位置来存放数据。
当需要查找某个键对应的值时,会从索引的位置开始线性探测数组,找到目标键值对或者空内存就意味着这一次查询操作的结束。
开放寻址法中对性能影响最大的是装载因子,它是数组中元素的数量与数组大小的比值。随着装载因子的增加,线性探测的平均用时就会逐渐增加,这会影响哈希表的读写性能。当装载率超过 70% 之后,哈希表的性能就会急剧下降,而一旦装载率达到 100%,整个哈希表就会完全失效,这时查找和插入任意元素的时间复杂度都是 $O(n)$ 的,这时需要遍历数组中的全部元素,所以在实现哈希表时一定要关注装载因子的变化。
拉链法
与开放地址法相比,拉链法是哈希表最常见的实现方法,大多数的编程语言都用拉链法实现哈希表,它的实现比较开放地址法稍微复杂一些,但是平均查找的长度也比较短,各个用于存储节点的内存都是动态申请的,可以节省比较多的存储空间。实现拉链法一般会使用数组加上链表,不过一些编程语言会在拉链法的哈希中引入红黑树以优化性能,拉链法会使用链表数组作为哈希底层的数据结构,我们可以将它看成可以扩展的二维数组: 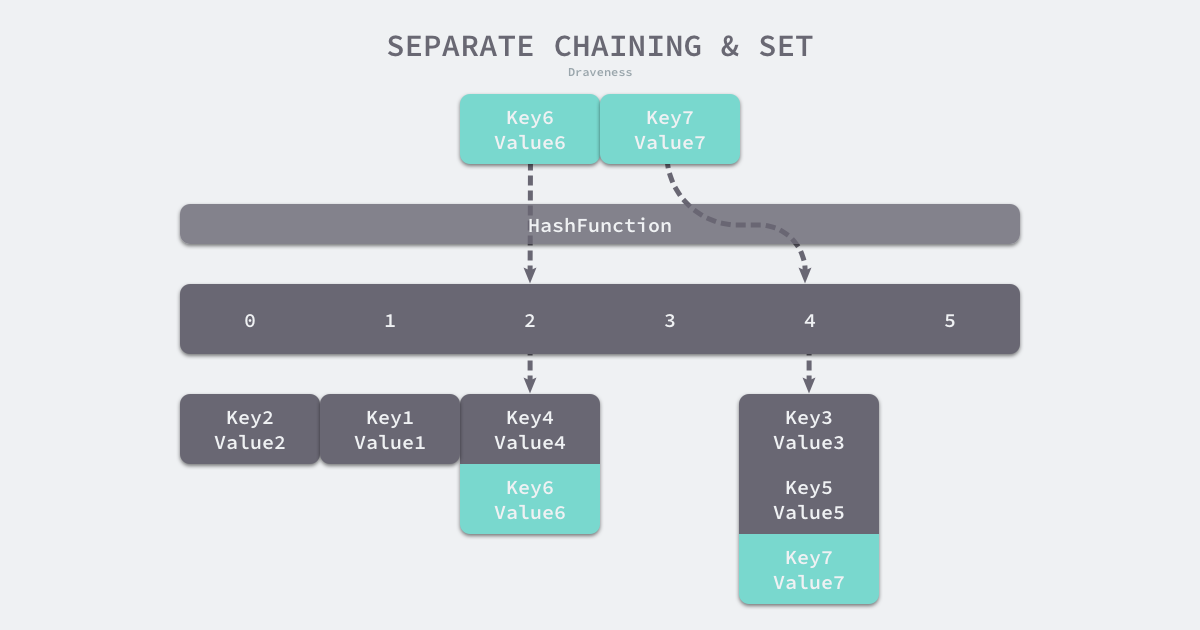
与开放寻址法不同的是,经过哈希计算后的index, 所在位置是一个用来存放数据的桶(bucket),通常使用链表实现桶数据的存储。
在一个性能比较好的哈希表中,每一个桶中都应该有 0~1 个元素,有时会有 2~3 个,很少会超过这个数量。计算哈希、定位桶和遍历链表三个过程是哈希表读写操作的主要开销,使用拉链法实现的哈希也有装载因子这一概念。
装载因子 = 元素数量 / 桶数量与开放地址法一样,拉链法的装载因子越大,哈希的读写性能就越差。
Golang的map
// A header for a Go map.
type hmap struct {
    // 元素个数,调用 len(map) 时,直接返回此值
	count     int
	flags     uint8
	// buckets 的对数 log_2
	B         uint8
	// overflow 的 bucket 近似数
	noverflow uint16
	// 计算 key 的哈希的时候会传入哈希函数
	hash0     uint32
    // 指向 buckets 数组,大小为 2^B
    // 如果元素个数为0,就为 nil
	buckets    unsafe.Pointer
	// 等量扩容的时候,buckets 长度和 oldbuckets 相等
	// 双倍扩容的时候,buckets 长度会是 oldbuckets 的两倍
	oldbuckets unsafe.Pointer
	// 指示扩容进度,小于此地址的 buckets 迁移完成
	nevacuate  uintptr
	extra *mapextra // optional fields
}

type bmap struct {
    topbits  [8]uint8
    keys     [8]keytype
    values   [8]valuetype
    pad      uintptr
    overflow uintptr
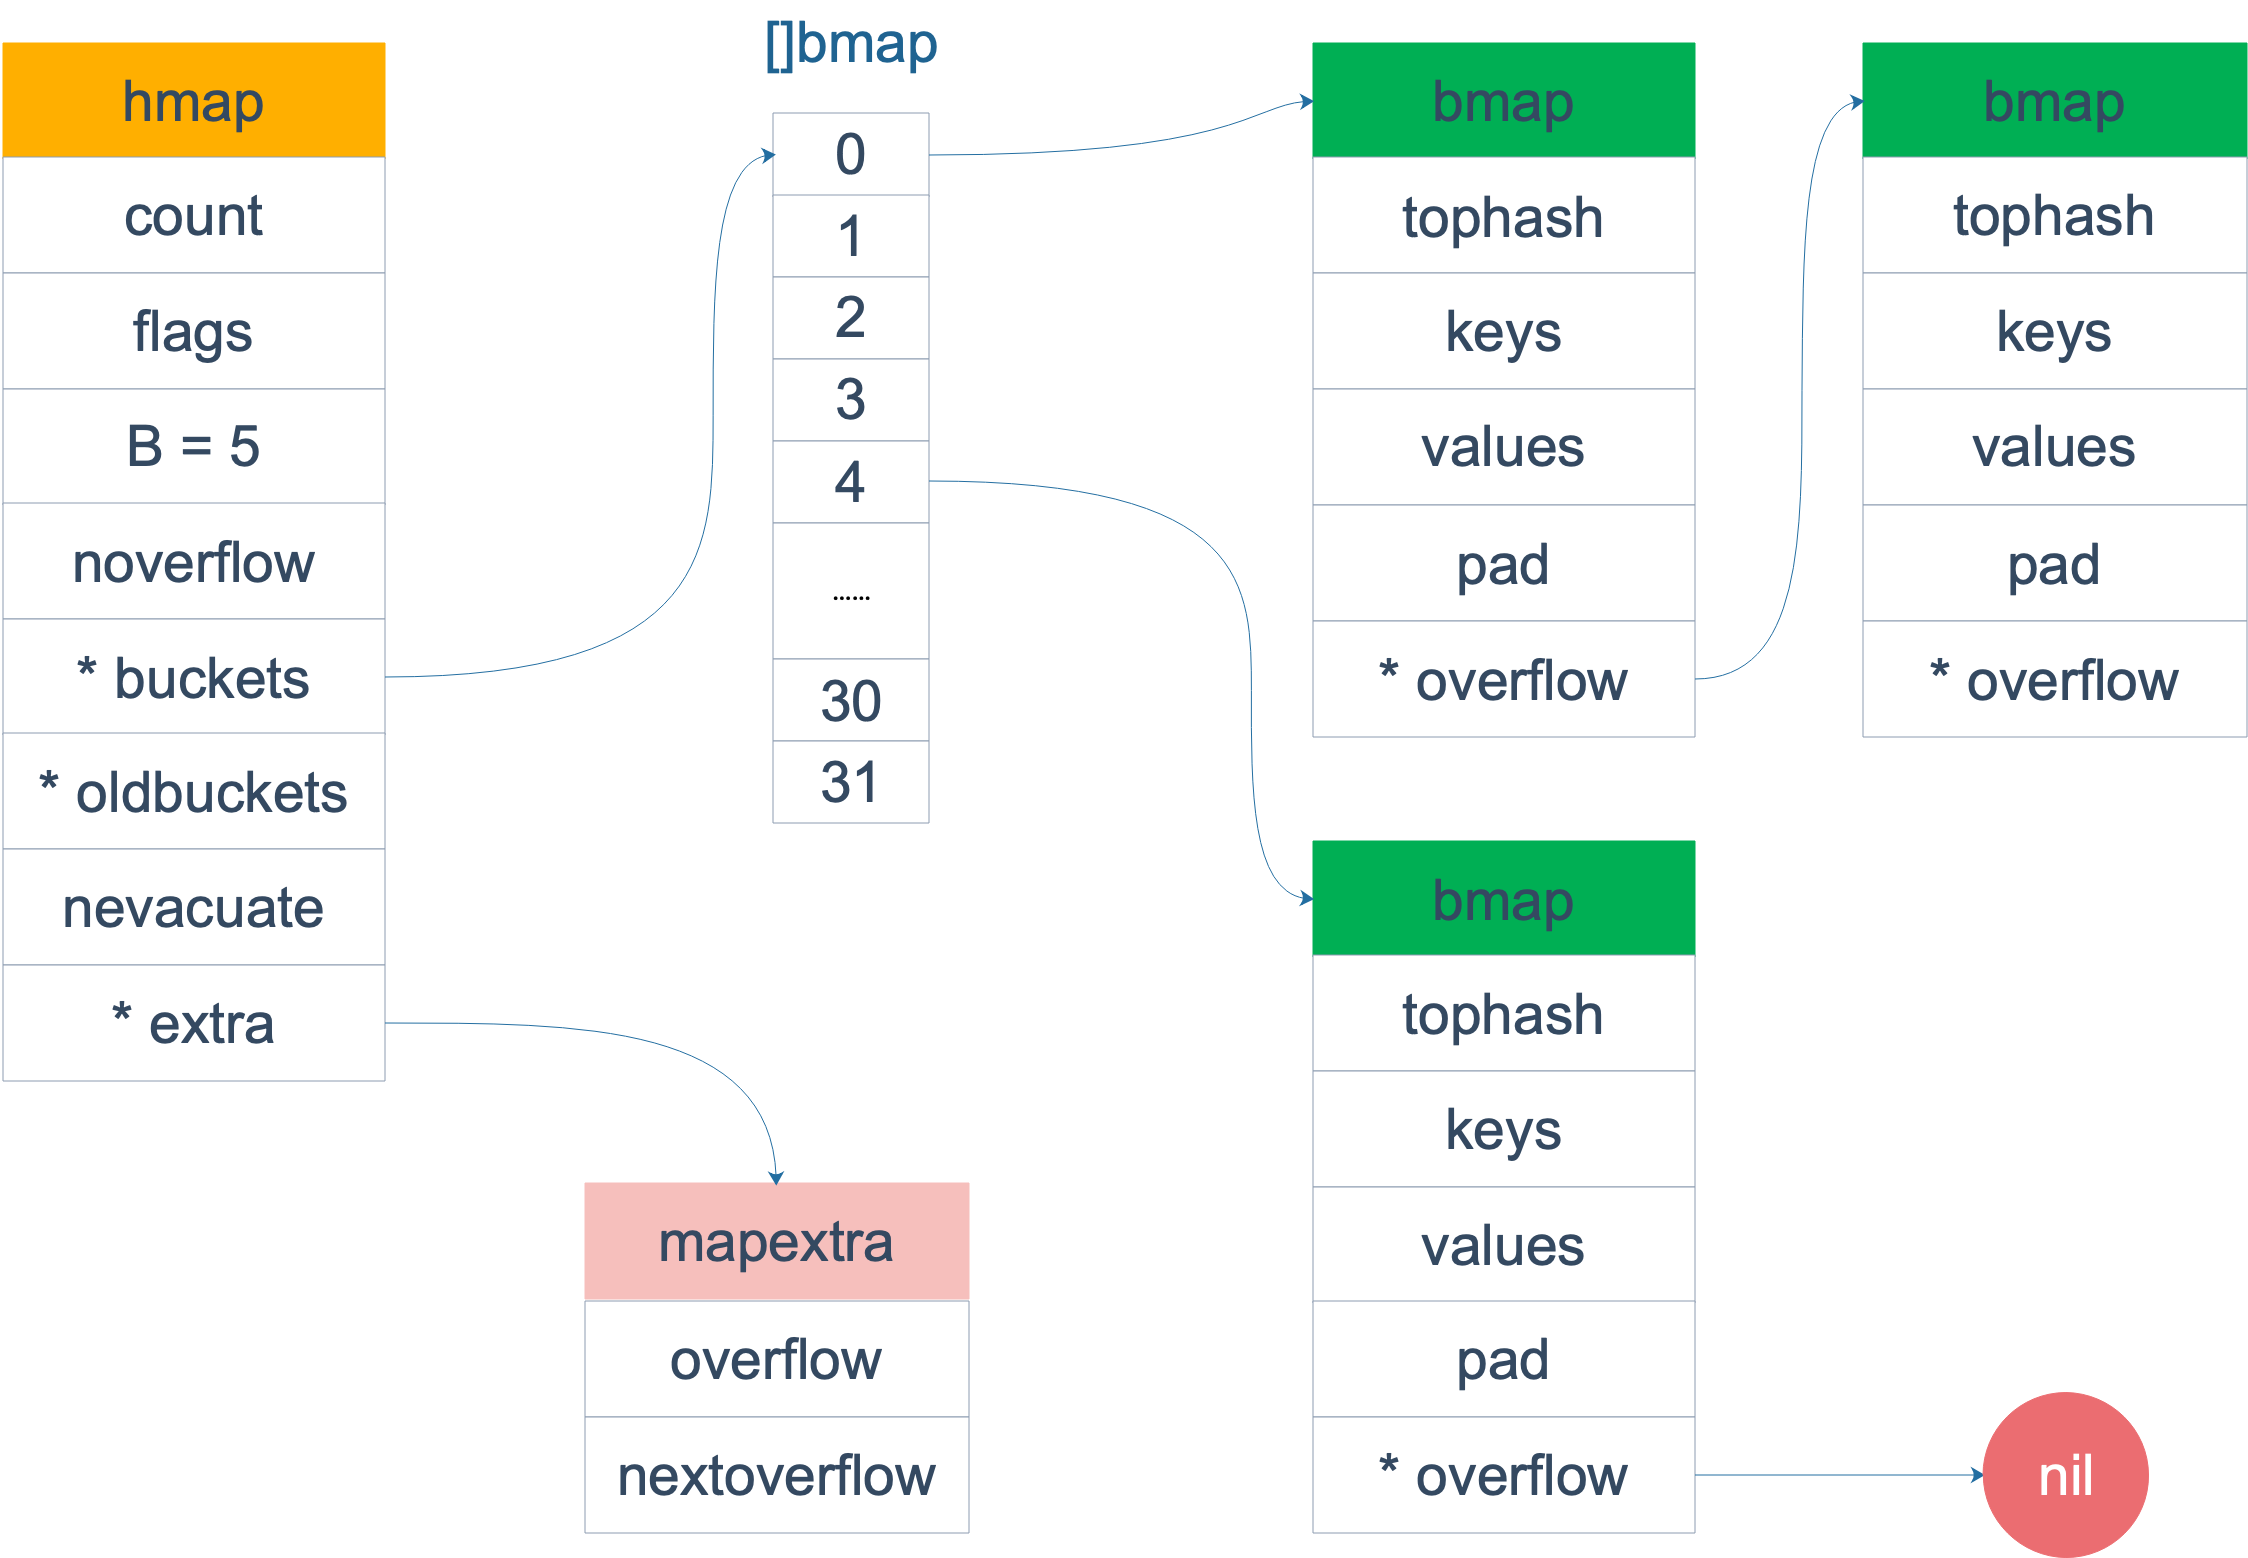
}count表示当前哈希表中的元素数量;B表示当前哈希表持有的buckets数量,但是因为哈希表中桶的数量都 2 的倍数,所以该字段会存储对数,也就是len(buckets) == 2^B;hash0是哈希的种子,它能为哈希函数的结果引入随机性,这个值在创建哈希表时确定,并在调用哈希函数时作为参数传入;oldbuckets是哈希在扩容时用于保存之前buckets的字段,它的大小是当前buckets的一半;bmap就是我们常说的“桶”,桶里面会最多装 8 个 key,这些 key 之所以会落入同一个桶,是因为它们经过哈希计算后,哈希结果是“一类”的。在桶内,又会根据 key 计算出来的 hash 值的高 8 位来决定 key 到底落入桶内的哪个位置(一个桶内最多有8个位置)。
bmap的内存布局如下图,HOB Hash 指的就是 top hash。 注意到 key 和 value 是各自放在一起的,并不是 key/value/key/value/... 这样的形式。主要是在某些情况下可以省略掉 padding 字段,节省内存空间, 内存排列更紧密。 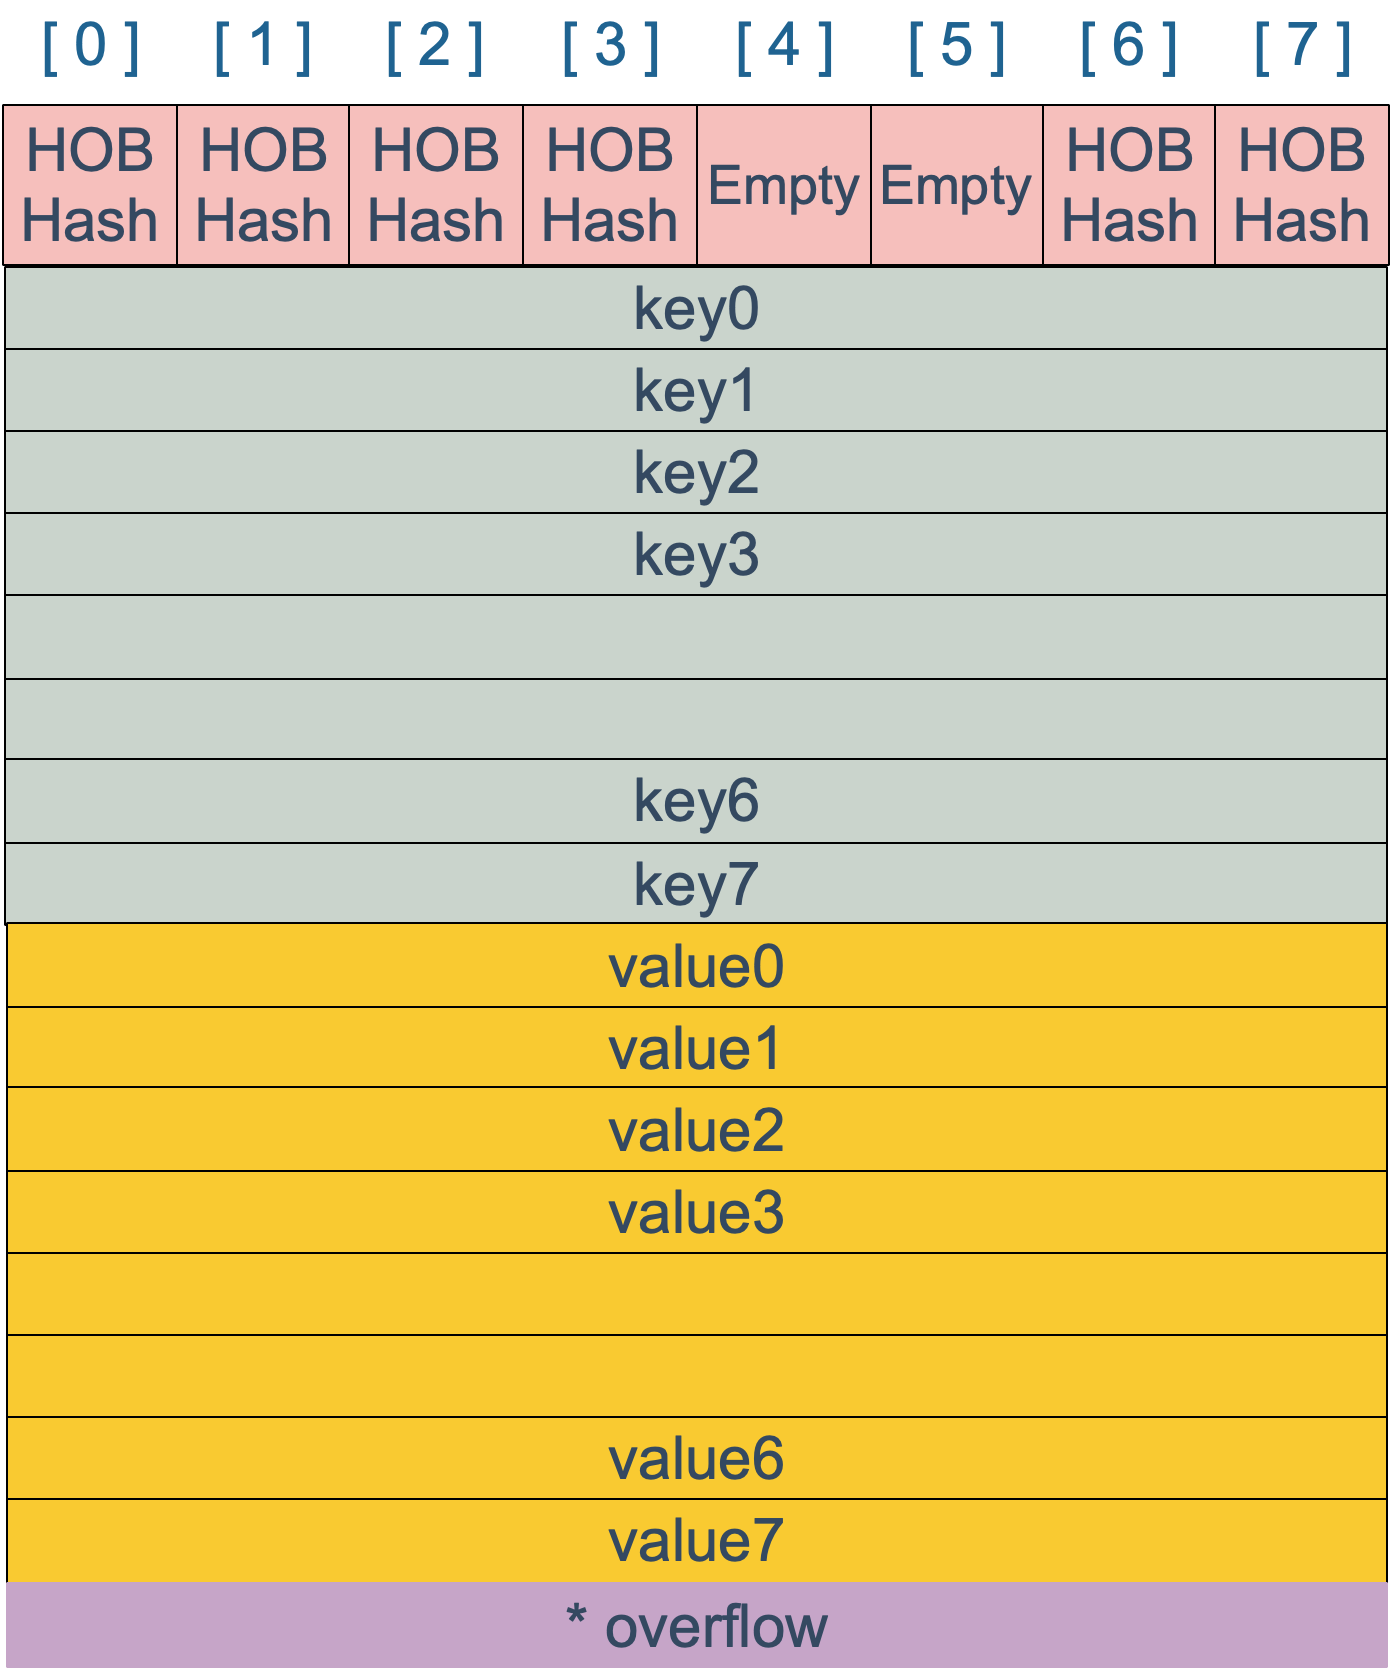
定位过程
key 经过哈希计算后得到哈希值,共 64 个 bit 位,计算它到底要落在哪个桶时,只会用到最后 B 个 bit 位。还记得前面提到过的 B 吗?如果 B = 5,那么桶的数量,也就是 buckets 数组的长度是 2^5 = 32。
例如,现在有一个 key 经过哈希函数计算后,得到的哈希结果是:
10010111 | 000011110110110010001111001010100010010110010101010 │ 01010用最后的 5 个 bit 位,也就是 01010,值为 10,也就是 10 号桶。这个操作实际上就是取余操作,但是取余开销太大,所以代码实现上用的位操作代替。 再用哈希值的高 8 位,找到此 key 在 bucket 中的位置,这是在寻找已有的 key。最开始桶内还没有 key,新加入的 key 会找到第一个空位,放入。 buckets 编号就是桶编号,当两个不同的 key 落在同一个桶中,也就是发生了哈希冲突。冲突的解决手段是用链表法:在 bucket 中,从前往后找到第一个空位。这样,在查找某个 key 时,先找到对应的桶,再去遍历 bucket 中的 key。
参考下图, 假定 B = 5,所以 bucket 总数就是 2^5 = 32。首先计算出待查找 key 的哈希,使用低 5 位 00110,找到对应的 6 号 bucket,使用高 8 位 10010111,对应十进制 151,在 6 号 bucket 中寻找 tophash 值(HOB hash)为 151 的 key,找到了 2 号槽位,这样整个查找过程就结束了。如果在 bucket 中没找到,并且 overflow 不为空,还要继续去 overflow bucket 中寻找,直到找到或是所有的 key 槽位都找遍了,包括所有的 overflow bucket。
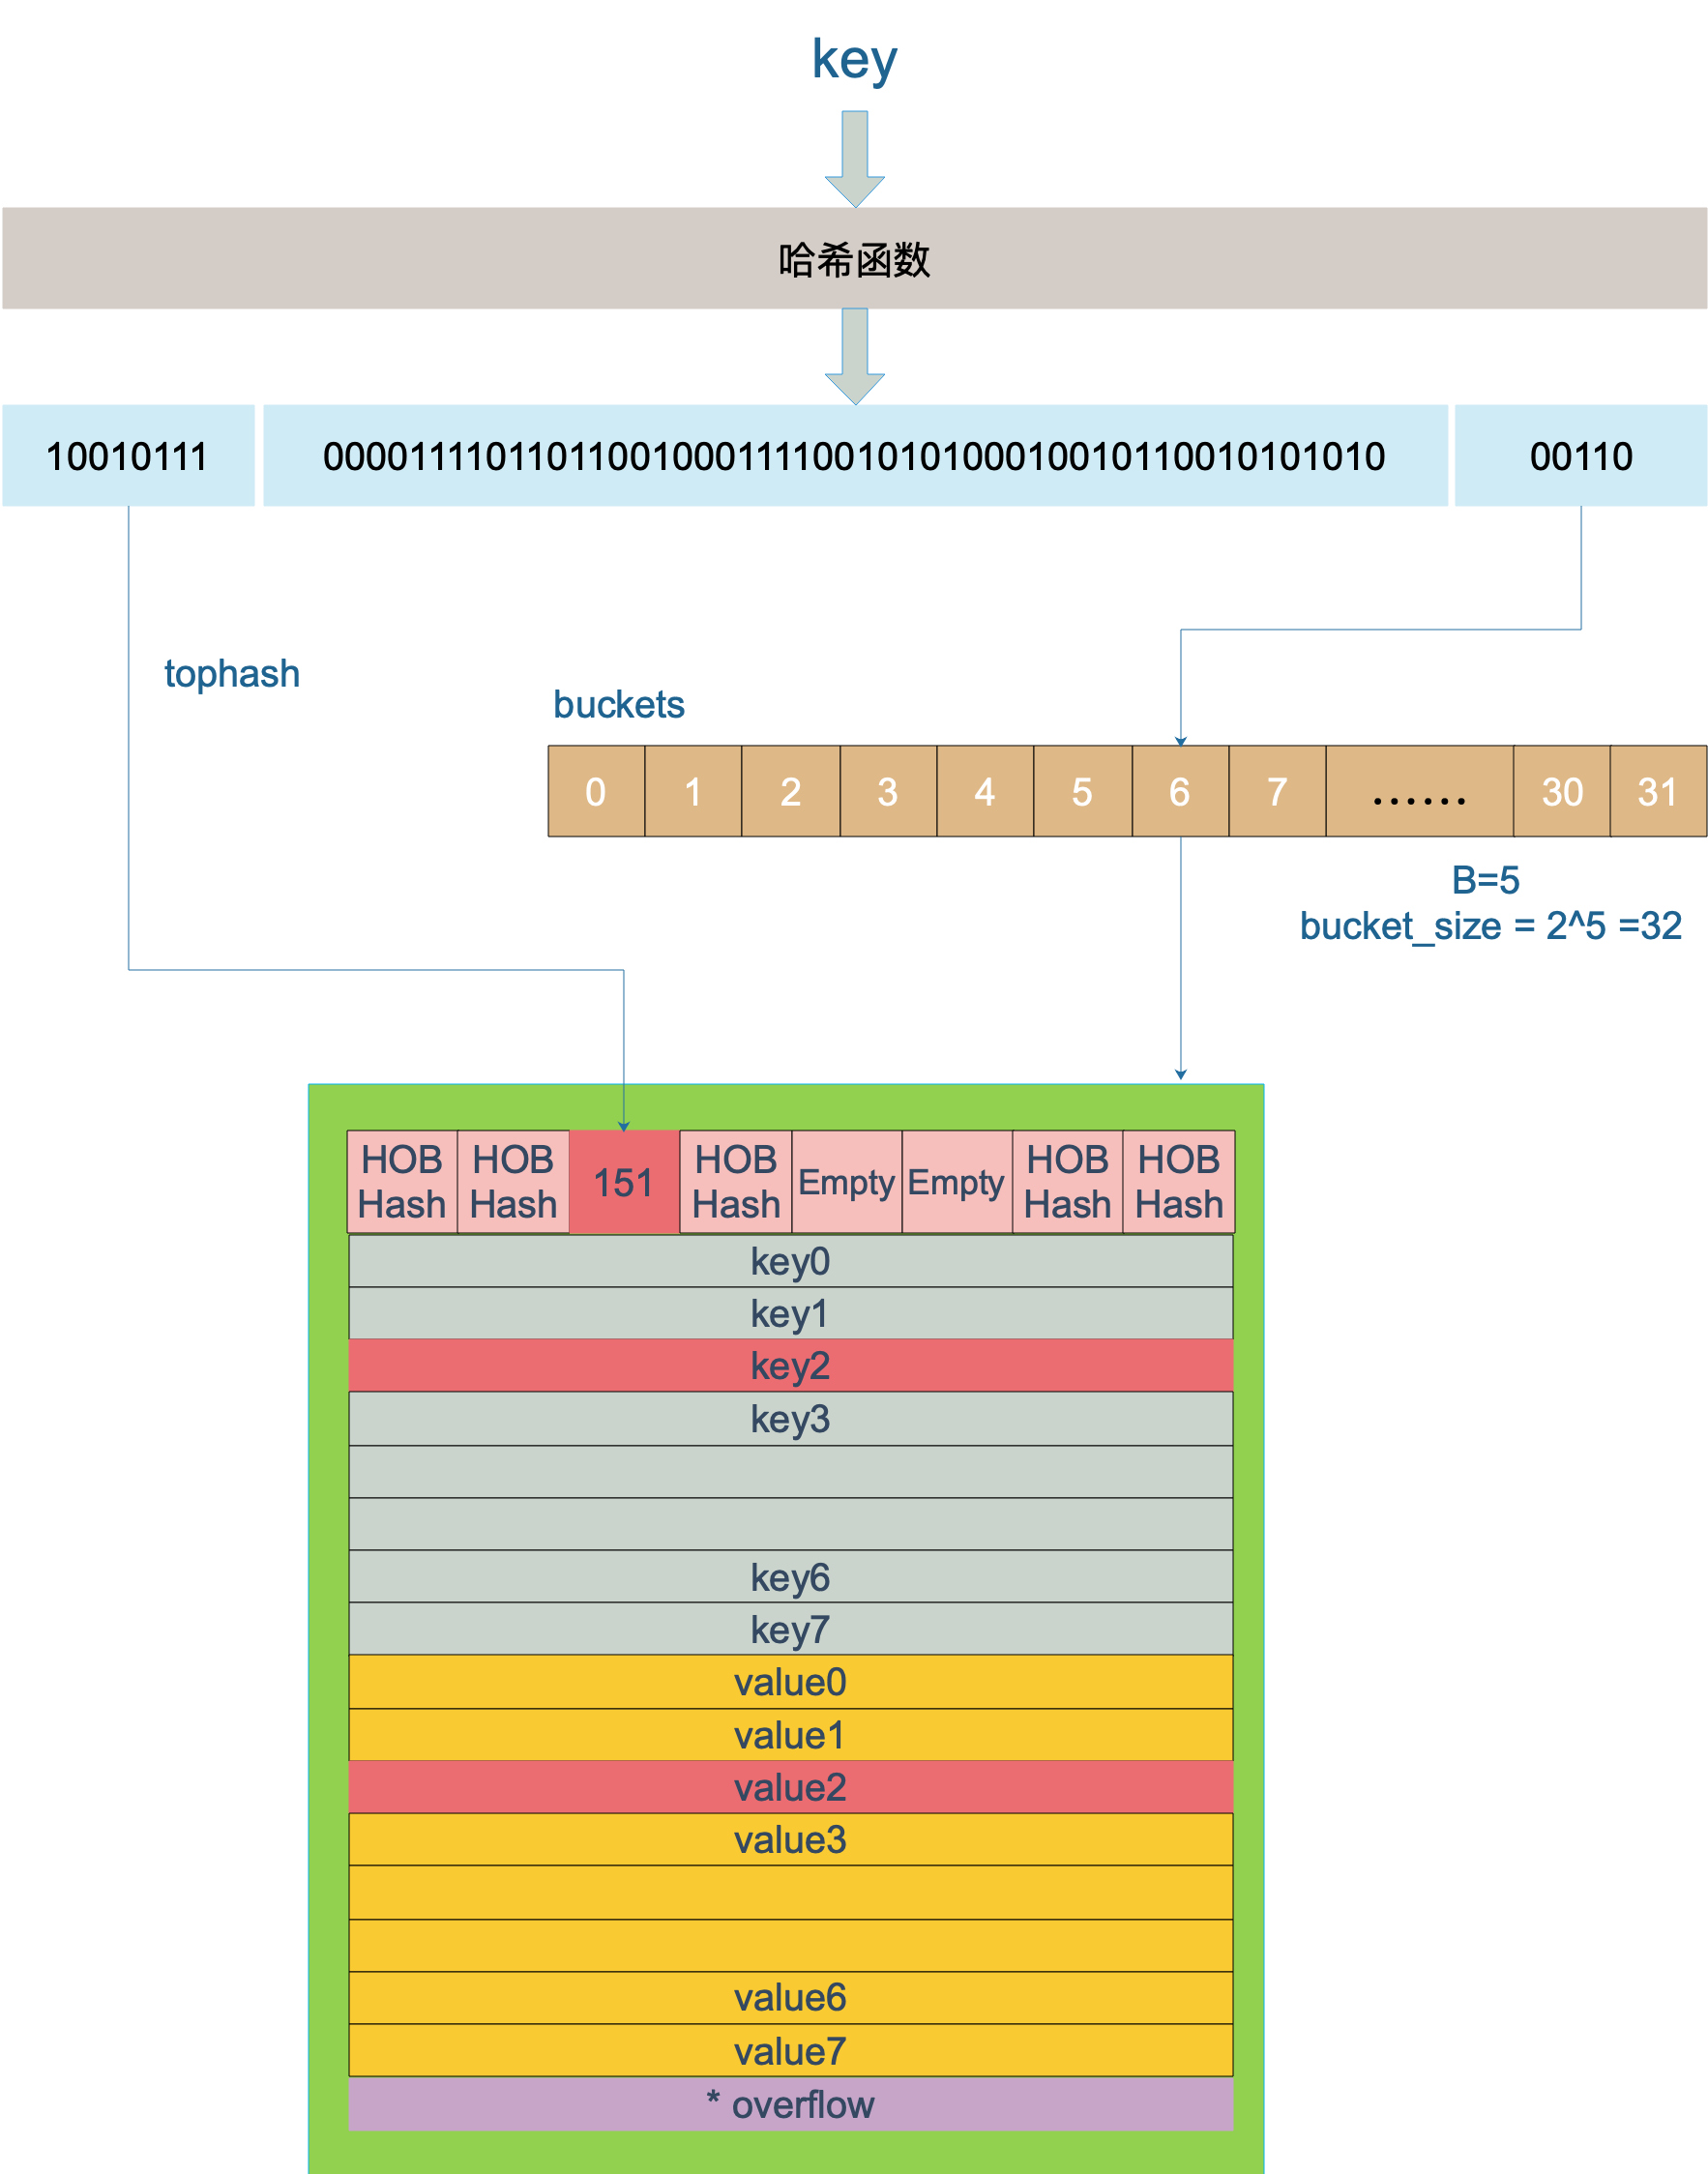
对于在桶中的查找过程如图: 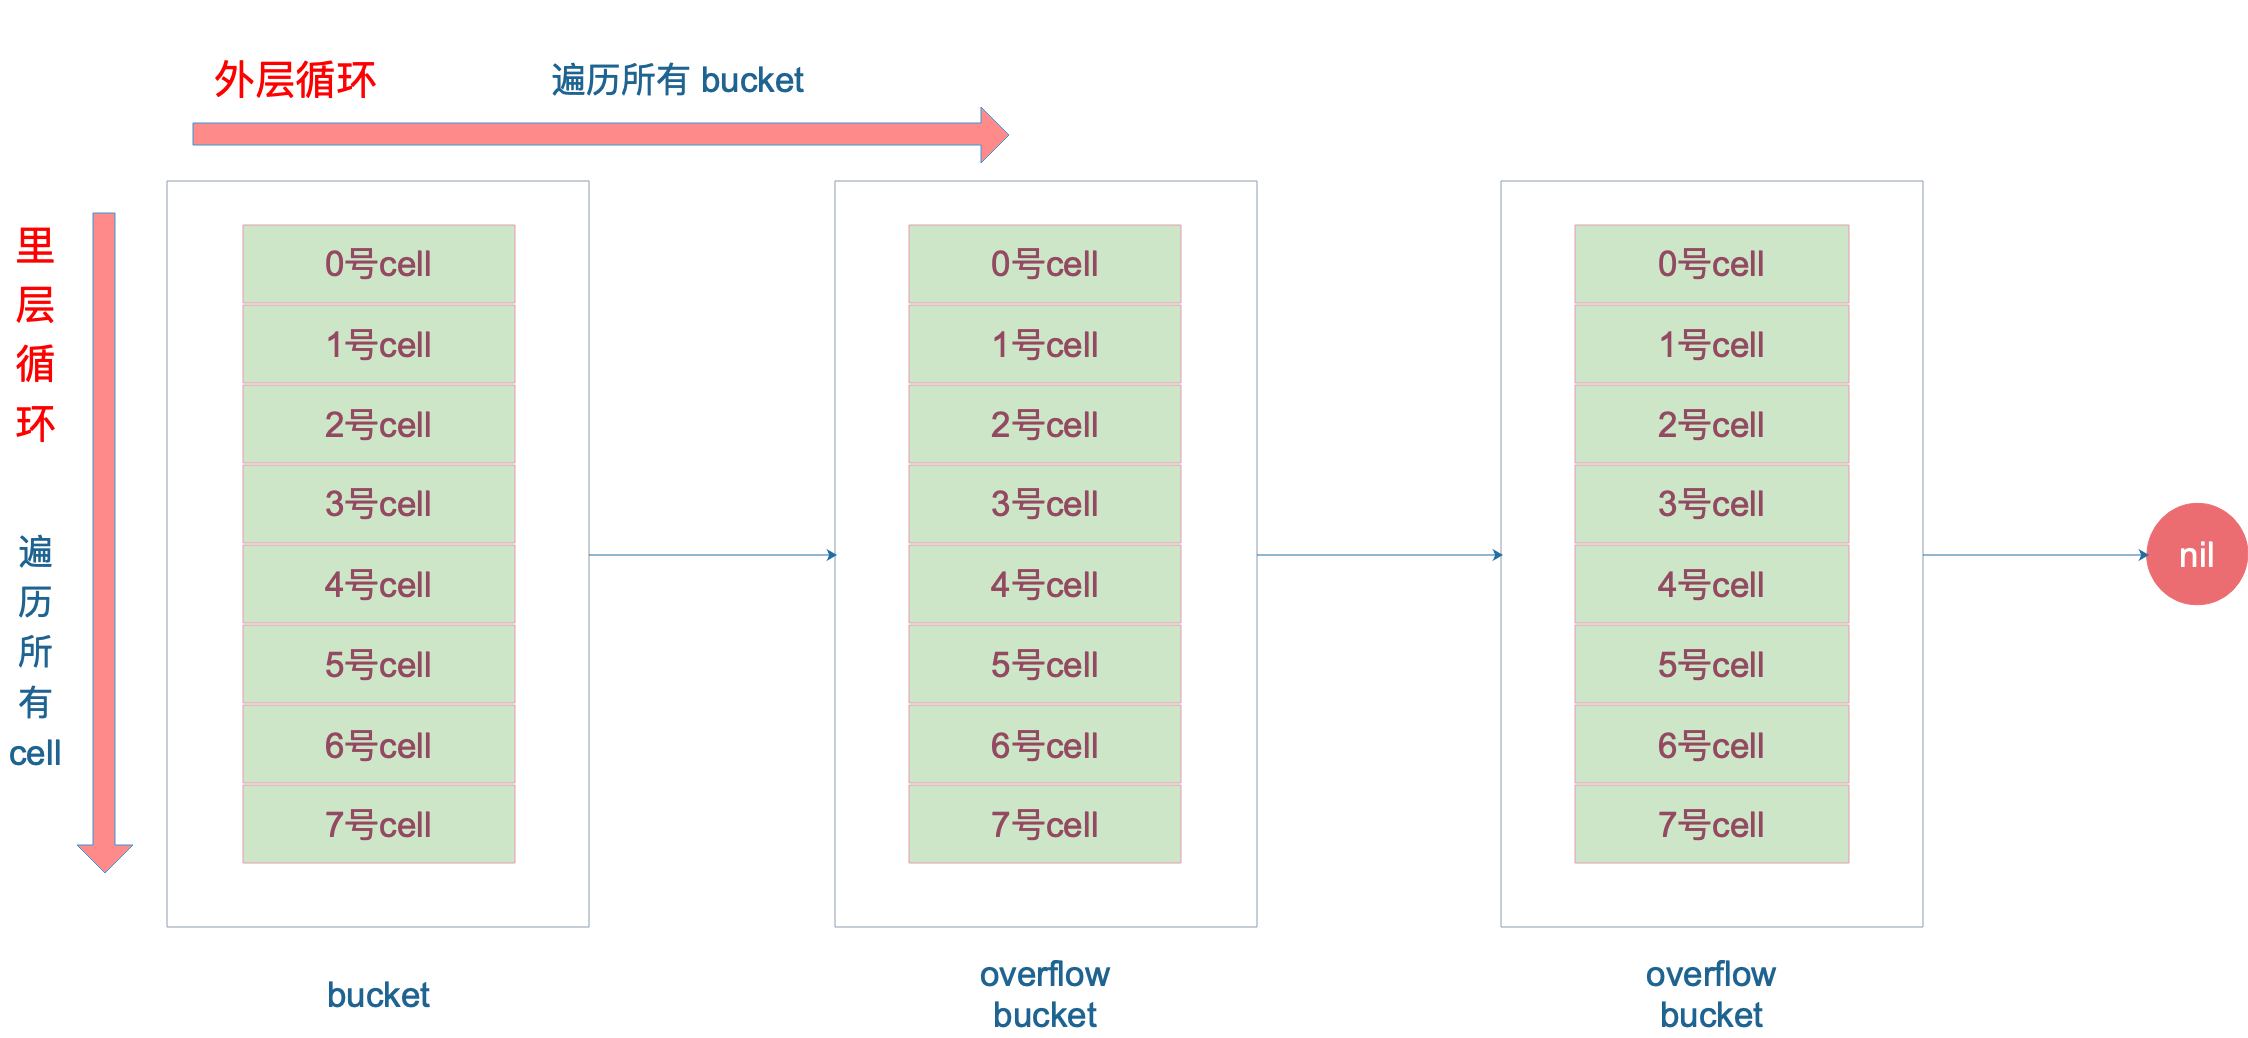
扩容
插入key时,可能会触发map 扩容。 扩容需要满足两个条件:
- 元素个数 count 大于 hash 桶数量(2^B)*6.5(装载因子超过6.5)。注意这里的 hash 桶指的是 hash 数组中的桶,不包括溢出的桶;
- overflow bucket数量:noverflow>=32768(1<<15) 或者 noverflow>=hash 数组中桶数量;
扩容分两类:
- 真扩容,扩到 hash 桶数量为原来的两倍,针对元素数量过多的情况;
- 假扩容,hash 桶数量不变,只是把元素搬迁到新的 map,针对溢出桶过多的情况。如果是假扩容,那么 hmap.flags 会被打上 sameSizeGrow 标识;
渐进式搬迁
扩容的启动函数 hashGrow 只负责分配新的桶数组、更新 hmap 中的字段(B、oldbuckets、buckets、nevacuate 等),不做任何数据拷贝。真正的元素搬迁(evacuate)分摊到后续的每次写操作中完成,这种设计称为渐进式扩容。
搬迁的触发时机
写操作(插入、删除)会调用 growWork,每次最多搬迁 2 个桶:
- 本次写操作涉及的旧桶;
- hmap.nevacuate 指向的桶,保证即使某些桶不被打扰,搬迁进度也在持续推进。
func growWork(t *maptype, h *hmap, bucket uintptr) {
	// 搬迁本次写操作涉及的旧桶
	evacuate(t, h, bucket&h.oldbucketmask())

	// 再搬迁一个桶,保证搬迁进度向前推进
	if h.growing() {
		evacuate(t, h, h.nevacuate)
	}
}
读操作不参与搬迁:扩容期间,读操作会判断对应的旧桶是否已搬迁完成,未完成则在旧桶中查找,完成了则在新桶中查找。
搬迁的规则
双倍扩容(真扩容)后,定位桶从取 hash 的低 B 位变为取低 B+1 位。旧桶中元素低 B 位相同,最终去向由 hash 值的第 B 位(新增的这一位)决定:
- 该位为 0:搬迁到 x = oldbucket 号新桶;
- 该位为 1:搬迁到 y = oldbucket + 旧桶数量(h.noldbuckets())号新桶。
也就是说,旧桶中的元素会分裂到两个新桶中,搬迁后每个桶的负载减半,查找长度变短。假设 B = 5,则旧桶数量是 32,1 号旧桶中的元素会分裂到 1 号新桶(x)和 33 号新桶(y)。
假扩容(等量扩容)的桶数量不变,所有元素原地搬到对应的新桶即可,不会分裂。
搬迁过程中,旧桶槽位的 tophash 会被改写成特殊标记:
- evacuatedX / evacuatedY:元素已搬迁到 x / y 桶;
- evacuatedEmpty:该槽位原本就是空的。
搬迁进度
hmap.nevacuate 记录搬迁进度:编号小于它的旧桶都已搬迁完成。每搬完一个桶,如果正好是 nevacuate 指向的桶,就推进进度:
func advanceEvacuationMark(h *hmap, t *maptype, newbit uintptr) {
	h.nevacuate++
	...
	if h.nevacuate == newbit { // 所有旧桶搬迁完成
		h.oldbuckets = nil // 释放旧桶数组
		if h.extra != nil {
			h.extra.oldoverflow = nil
		}
		h.flags &^= sameSizeGrow
	}
}
当 nevacuate 等于旧桶数量时,扩容完成:oldbuckets 置为 nil,此后读写只访问新桶数组。
还有一个细节:扩容尚未完成时,即使再次满足扩容条件也不会启动新一轮扩容(growing 判断拦截),而是继续完成当前这一轮搬迁。
删除
删除操作由 runtime.mapdelete 实现,主流程与查找非常相似:先定位桶、比对 tophash,再比较完整的 key。整体流程如下:
func mapdelete(t *maptype, h *hmap, key unsafe.Pointer) {
	if h == nil || h.count == 0 {
		return
	}
	...
	hash := t.hasher(key, uintptr(h.hash0))
	// 打上 hashWriting 标记:任何写操作进行时都会打上该标记
	h.flags ^= hashWriting

	// 扩容中:先执行一次搬迁
	if h.growing() {
		growWork(t, h, bucket)
	}
	...
search:
	for ; b != nil; b = b.overflow(t) {
		for i := 0; i < bucketCnt; i++ {
			if b.tophash[i] != top {
				continue
			}
			// tophash 相同,再比较完整的 key
			if !t.Key.Equal(key, k2) {
				continue
			}
			// 命中目标:
			// 1. 清除 key/value 内存(含指针时清理,避免内存泄漏)
			// 2. 槽位标记为 emptyOne
			b.tophash[i] = emptyOne
			// 3. 若后面已无元素,把尾部连续的 emptyOne 修正为 emptyRest
			...
			h.count--
			break search
		}
	}
	...
	// 结束前检查标记:若标记已被清除,说明有并发写
	if h.flags&hashWriting == 0 {
		fatal("concurrent map writes")
	}
	h.flags &^= hashWriting
}
流程要点:
- map 为 nil 或元素数量为 0 时直接返回,因此删除不存在的 key 是无操作,不会报错;
- 进入时打上 hashWriting 标记、退出时检查并清除,防止并发读写;
- 正在扩容时先执行 growWork 搬迁;
- 定位桶后先比对 tophash 快速过滤,再比较完整的 key;
- 命中后清除 key/value 内存,槽位标记为 emptyOne,并修正 emptyRest;
- count 减一,若 count 归零则重置 hash0(增加随机性,防止哈希洪水攻击)。
emptyOne 与 emptyRest
这两个标记是删除操作的关键,也是查找优化的基础。查找时会利用 emptyRest 提前终止:
if b.tophash[i] != top {
	if b.tophash[i] == emptyRest {
		break search // 该槽位及后面全部为空,提前结束查找
	}
	continue
}- emptyOne:该槽位当前为空,但后面可能还有元素,需要继续查找;
- emptyRest:该槽位及其后面所有槽位(包括溢出桶)都为空,查找可以直接结束。
删除元素后,如果它后面已经没有别的元素,就把从它开始向前连续的一段 emptyOne 修正为 emptyRest(必要时会跨溢出桶向前处理),保证查找能尽早终止。这也是为什么删除元素时需要“向前”修正标记,而不是简单置空就结束。
一些细节
- map 只有扩容,没有缩容:删除大量元素后底层桶数组不会缩小,内存不会归还。需要释放时只能重新 make 一个 map,把有效元素拷贝过去;
- 删除同样会触发 growWork,所以即使后续只有删除操作,扩容也能持续推进直至完成。
遍历
Go 的 map 遍历是无序的,即使 map 的内容没有变化,每次遍历输出的顺序也可能不同。这与遍历的起始位置有关,runtime 在初始化迭代器时会生成一个随机数:
- 用随机数的低位 bit 决定从哪个桶(bucket)开始遍历;
- 用随机数的其余 bit 决定从桶内哪个槽位(cell)开始。
// runtime/map.go mapiterinit
// decide where to start
r := uintptr(fastrand())
...
it.startBucket = r & bucketMask(h.B)           // 随机选择起始桶
it.offset = uint8(r >> h.B & (bucketCnt - 1)) // 随机选择桶内的起始槽位
从随机的起始桶、起始槽位开始,遍历完一个桶再遍历下一个桶(越界则回到 0 号桶继续),当再次回到起始位置时,整个遍历结束。
因此,依赖遍历顺序的代码会表现得时对时错,且难以排查。如果确实需要有序遍历,需要先把所有 key 取出排序,再按序访问:
m := map[string]int{"b": 2, "c": 3, "a": 1}
keys := make([]string, 0, len(m))
for k := range m {
    keys = append(keys, k)
}
sort.Strings(keys)
for _, k := range keys {
    fmt.Println(k, m[k])
}
注意事项
并发读写线程安全
map 不是并发安全的。当一个 goroutine 在写 map,另一个 goroutine 同时读写 map 时,runtime 检测到会直接抛出 fatal error 导致整个程序崩溃,且无法通过 recover 捕获:
fatal error: concurrent map writes
fatal error: concurrent map read and map write
常见的处理方式:
- 使用
sync.RWMutex加锁保护 map,适合读写都比较频繁的场景; - 使用
sync.Map,适合读多写少、或者多个 goroutine 读写不相交 key 集合的场景; - 使用分片锁,把 key 打散到多个小 map 中各自加锁,减少锁竞争。
sync.Map 是标准库提供的并发安全 map,常用方法如下:
var m sync.Map // 零值即可使用,无需 make 初始化

m.Store("a", 1)                    // 写入
v, ok := m.Load("a")               // 读取
m.Delete("a")                      // 删除
v, loaded := m.LoadOrStore("a", 1) // 存在则读取,不存在则写入
sync.Map 内部将数据拆分为 read(只读)和 dirty(可写)两份,读操作大多数情况下不用加锁,因此读多写少的场景性能很好;但写多的场景需要频繁维护两份数据,性能反而不如 sync.RWMutex + map。
同时遍历和删除
对于遍历过程中修改 map 的行为,官方文档的描述是:
- 删除还没有遍历到的 key,这些 key 不会再被遍历到;
- 删除已经遍历过的 key,不影响遍历的继续;
- 遍历时新增的 key,可能被遍历到,也可能不被遍历到。
因此尽量不要在遍历过程中修改 map,如果一定要修改,建议先把要删/改的 key 收集起来,遍历结束后再统一处理。
key 的顺序
map 是无序的(原因见"遍历"一节),因此:
- 不要依赖“第一个元素”“最后一个元素”这类语义,任何依赖遍历顺序的业务逻辑都是不稳定的;
- 使用
encoding/json序列化 map 时,会按 key 的字典序输出(按字节比较),而 gob、msgpack 等方式不保证任何顺序; - 业务需要稳定顺序时,应该显式对 key 排序,或者改用有序的数据结构。
map 的比较
map 之间不能使用 == 比较,唯一合法的比较对象是 nil:
m1 := map[string]int{"a": 1}
m2 := map[string]int{"a": 1}

fmt.Println(m1 == nil) // 合法,判断 map 是否为 nil
fmt.Println(m1 == m2)  // 编译错误: invalid operation: m1 == m2 (map can only be compared to nil)
判断两个 map 是否包含相同的键值对,常见的方式有:
- 手写循环:先比较长度,再逐个 key 比较对应的 value;
reflect.DeepEqual:灵活但性能较差,且对 nil 切片与空切片等语义是区分对待的;maps.Equal:Go 1.21 之后的标准库 maps 包提供,底层同样是循环逐个比较。
// 方式一:手写循环
func equal(m1, m2 map[string]int) bool {
    if len(m1) != len(m2) {
        return false
    }
    for k, v1 := range m1 {
        if v2, ok := m2[k]; !ok || v1 != v2 {
            return false
        }
    }
    return true
}

// 方式三:maps.Equal(Go 1.21+)
equal := maps.Equal(m1, m2)